LSTM
Rede neural que lê a sequência das últimas semanas.
Como funciona
O LSTM é uma rede neural feita para sequências. Ele lê as semanas em ordem e guarda na “memória” o que importa: se a curva está subindo, se acelerou, se já passou do pico.
Cada UF tem uma representação própria aprendida, o que permite ao modelo dar um peso diferente à mesma tendência em estados diferentes. Leva mais tempo para treinar que os demais.
- Entradas
- As 12 últimas semanas de incidência, a UF (como vetor aprendido) e a época do ano.
- O que prevê
- Incidência de casos prováveis por 100 mil habitantes, 1 a 4 semanas à frente da origem.
- Configuração
- Duas camadas LSTM (60 e 20 unidades)
- Dropout 0,5
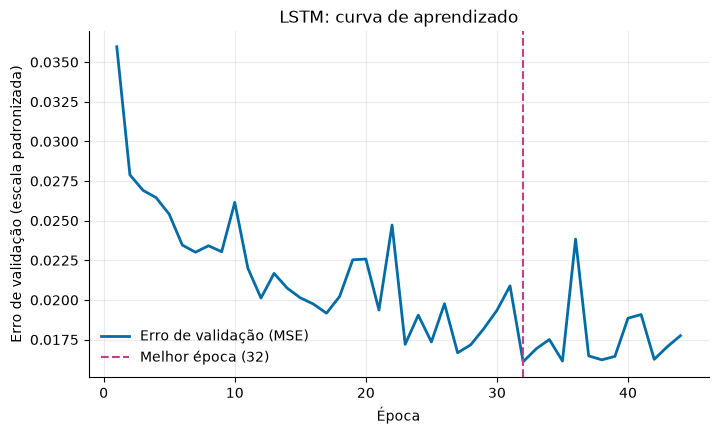
- Até 200 épocas, parada antecipada com paciência 12
- Lotes de 64 janelas
- Referência
- Hochreiter e Schmidhuber, Long Short-Term Memory (1997).
- Versão vigente
- 1
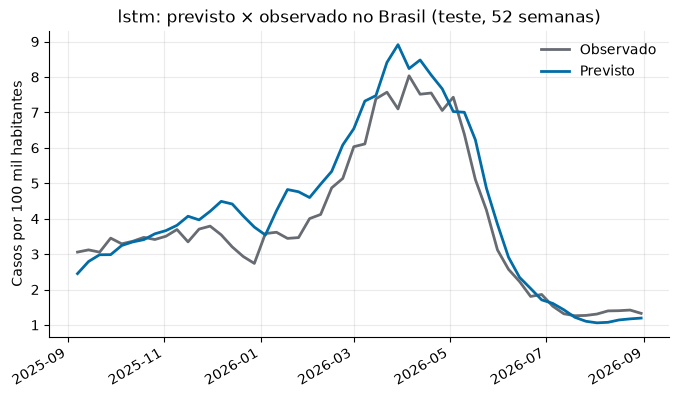
Erro por horizonte — Brasil
| Horizonte | NRMSE | MAE | RMSE | R² |
|---|---|---|---|---|
| H1 | 0,098 | 0,51 | 0,67 | 0,89 |
| H2 | 0,185 | 1,02 | 1,26 | 0,59 |
| H3 | 0,226 | 1,27 | 1,53 | 0,39 |
| H4 | 0,305 | 1,71 | 2,07 | -0,11 |
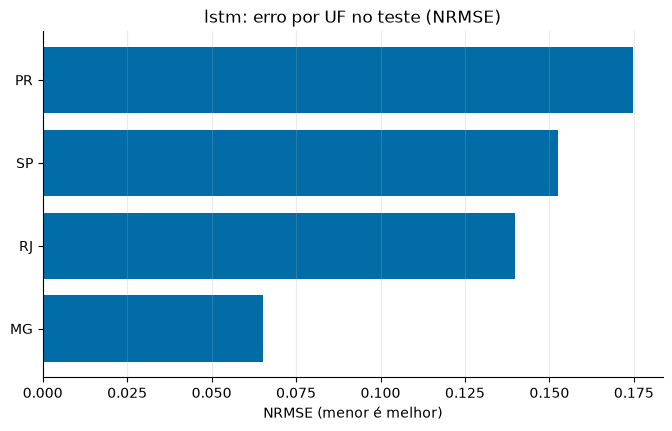
Erro por UF — 1 semana à frente
| UF | NRMSE | MAE | R² |
|---|---|---|---|
| Minas Gerais | 0,065 | 0,70 | 0,96 |
| Rio de Janeiro | 0,140 | 0,19 | 0,75 |
| São Paulo | 0,153 | 0,73 | 0,72 |
| Paraná | 0,175 | 0,66 | 0,60 |
Figuras do treino — 1 semana à frente
Como a previsão é feita
- Cada modelo lê as 12 semanas terminando na origem, 30/08/2026.
- Há 4 modelos por tipo, um para cada horizonte: o H1 responde “quantos casos na semana seguinte?”, o H2 “duas semanas depois?”, e assim até o H4.
- Todos recebem a mesma janela. Uma semana prevista não é calculada a partir da anterior, e por isso o erro cresce com o horizonte.
- As semanas previstas (06/09/2026 a 27/09/2026) ficam antes do dado mais recente (25/10/2026): é uma previsão retroativa, que dá para conferir com o que foi notificado depois.